翻译与授权说明
本文依据 Jiale Wei、Xiang Ying、Tao Gao、Fangyi Bao、Felix Tao 与 Jingbo Shang 的论文 AI-native Memory 2.0: Second Me(arXiv:2503.08102v2,2025)翻译整理。原文采用 Creative Commons Attribution 4.0 International(CC BY 4.0) 许可。本页为非官方中文翻译,保留原文结构、表格与图示;术语与排版有所转换。原文:arXiv:2503.08102v2。
摘要
人与外部世界的互动从根本上说包含个人记忆的交换——无论对象是其他个人、网站、应用程序,还是未来的 AI 智能体。这类互动中有相当一部分是重复的,用户不得不在不同情境中一再提供相同信息。浏览器凭据存储、自动填表机制和统一身份认证系统等现有方案,试图通过充当中介来存储并调取常用用户数据,以减少这种重复。大语言模型(LLM)的出现,为以 AI 原生范式重新定义记忆管理带来机遇:Second Me。Second Me 是一个智能、持久的记忆卸载系统,能够保留、组织并动态运用特定用户的知识。它作为用户互动中的中介,可以自主生成理解上下文的回复、预填所需信息,并与外部系统顺畅沟通,从而显著降低认知负担和交互摩擦。与传统的记忆存储方案不同,Second Me 借助基于 LLM 的记忆参数化,不再局限于静态保存数据。这使得记忆能够以结构化方式组织,支持上下文推理和自适应检索,从而更系统、更智能地管理记忆。随着 Second Me 这类 AI 驱动的个人智能体逐渐融入数字生态系统,它也代表着增强人与现实世界互动的重要一步:借助持久、具备上下文感知能力并可自我优化的记忆系统来扩展人类能力。作者已在 GitHub 开源可完全本地化部署的系统。
1 引言
人与外部世界的互动高度依赖记忆:我们会在对话中回想信息,也会在不同数字平台上反复填写个人数据。这种重复会造成认知疲劳,并妨碍人们顺畅地使用技术。自动填表和统一身份认证等现有方案,可以通过存储、调取常用信息来减轻部分负担;但它们只是静态资料库,缺乏上下文推理和适应能力,仍需要用户手动管理、核验信息,因此体验零散且不理想。
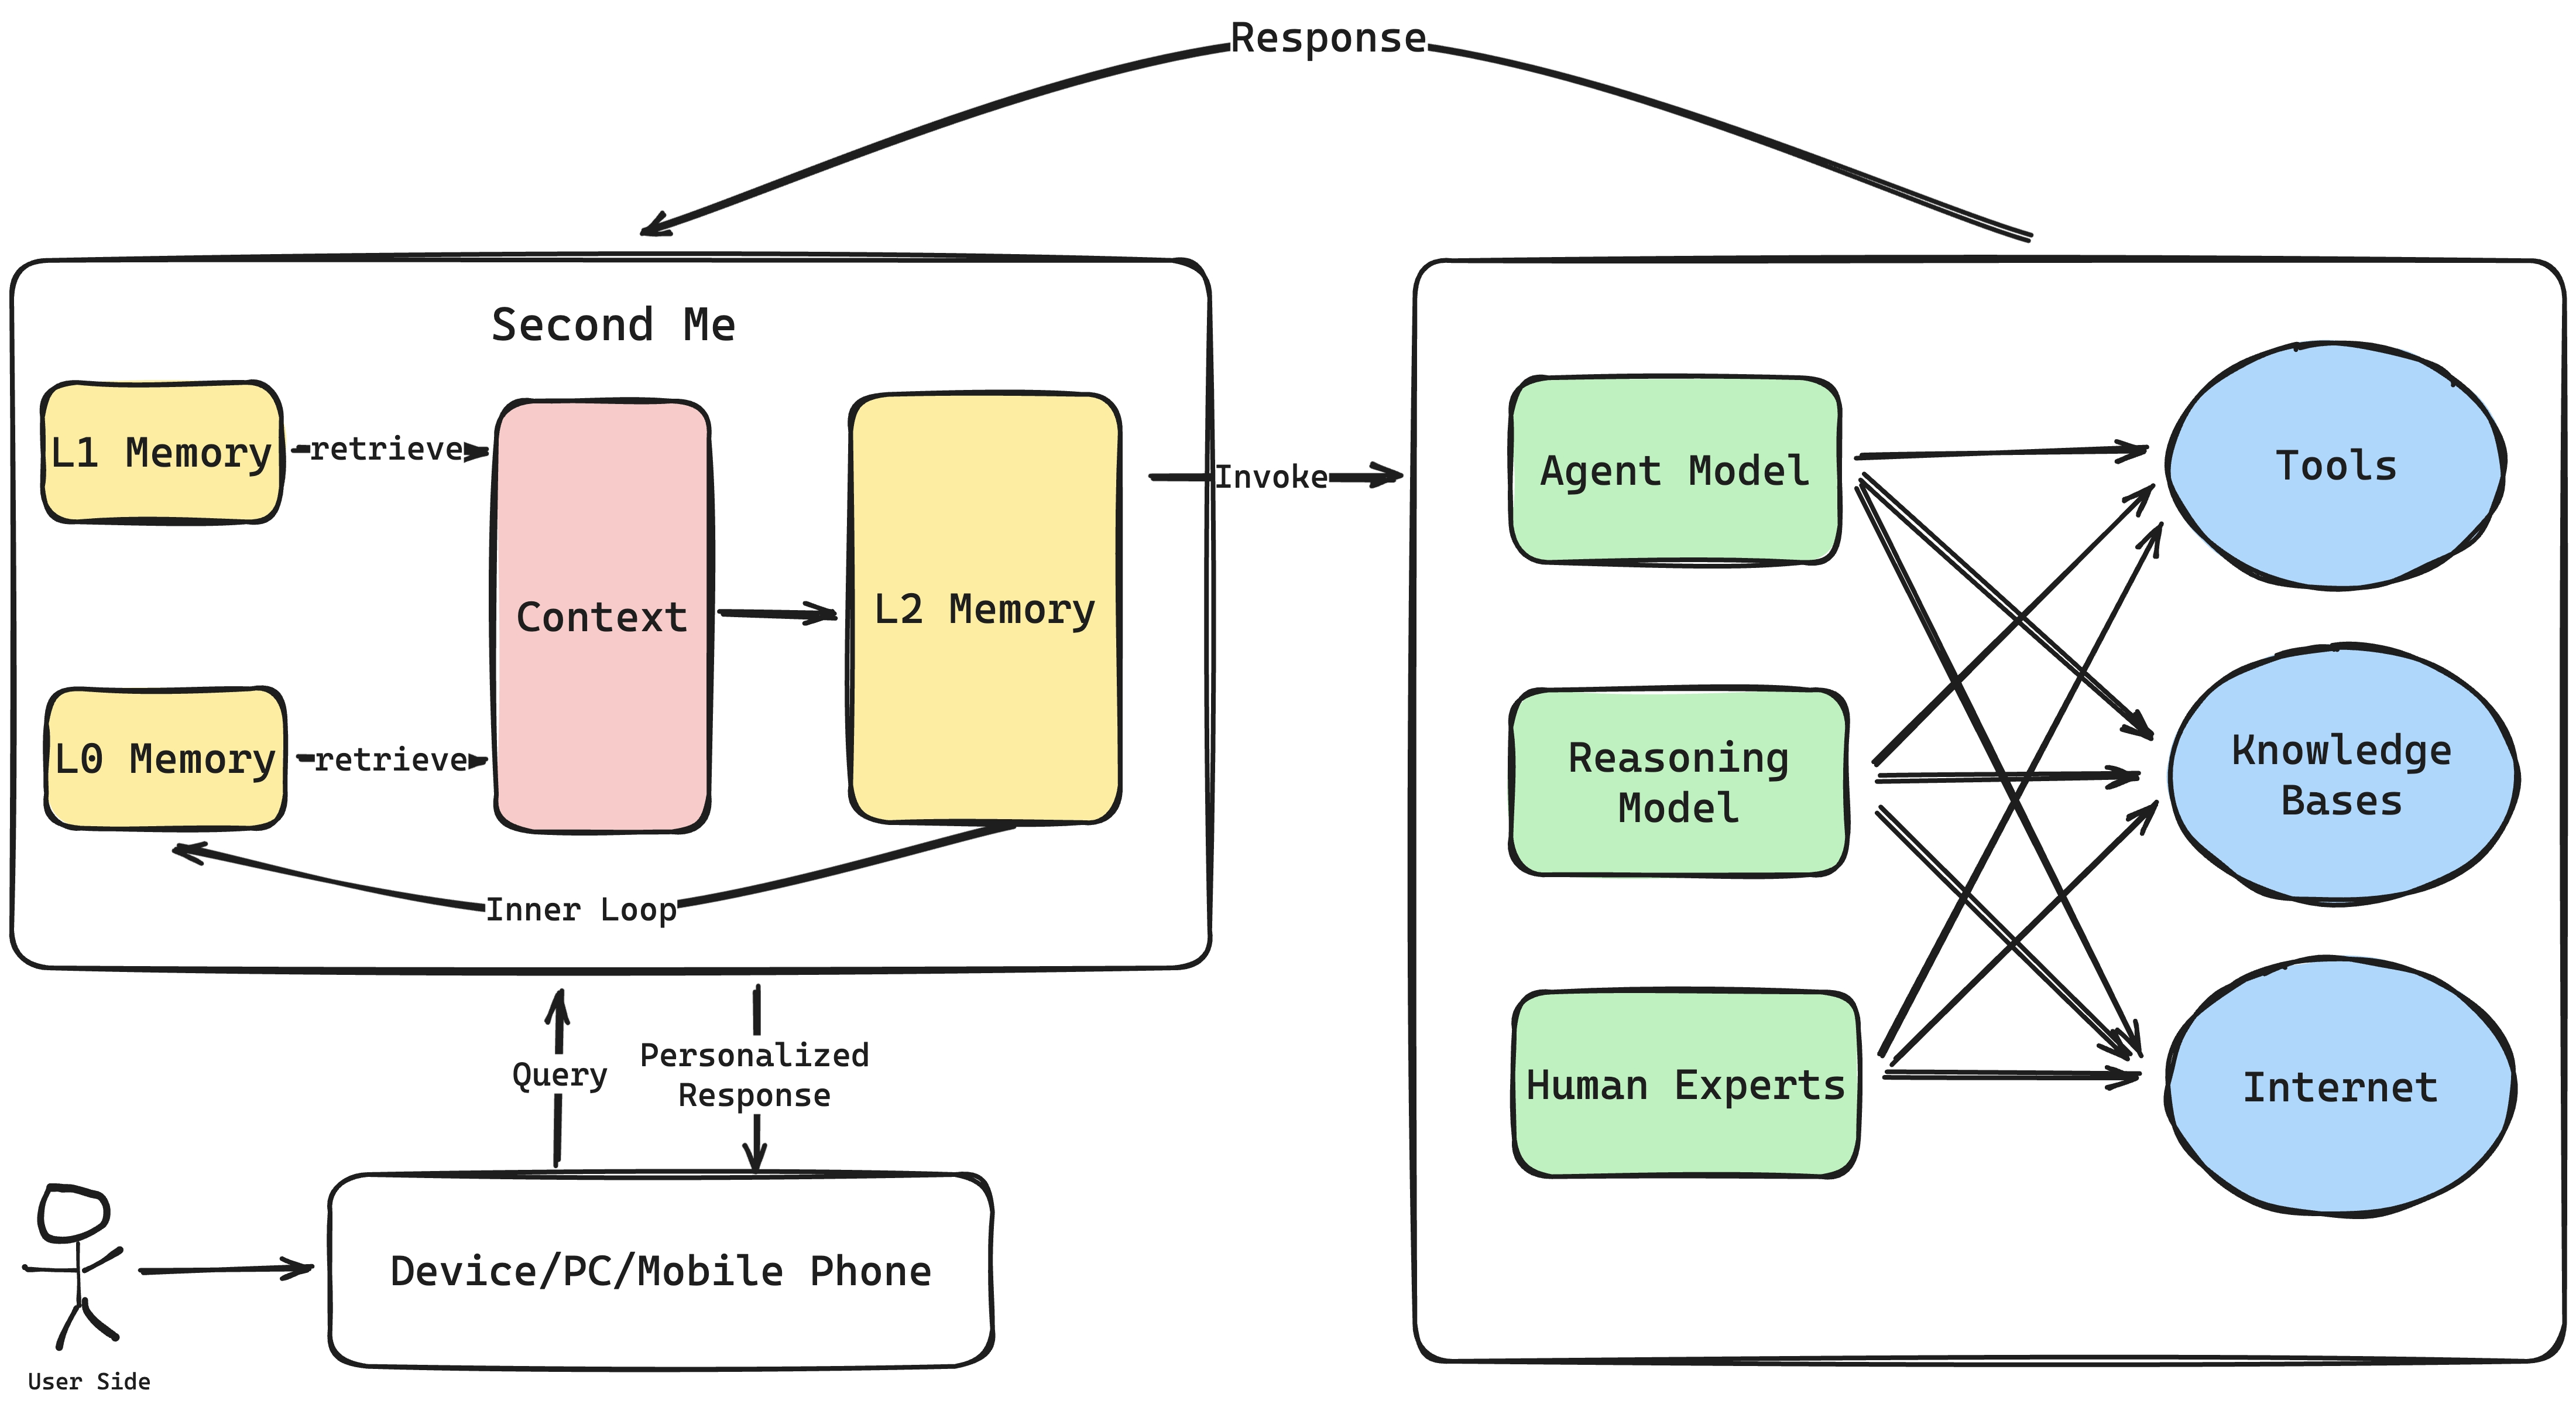
大语言模型的兴起,为以 AI 原生方式重新定义记忆管理带来了变革性机遇。如图 1 所示,本文提出 Second Me:一种智能、持久的记忆卸载系统,在人机互动中充当动态中介。与传统存储方案不同,Second Me 是一种自适应、具备上下文感知能力的助手,能够自主检索、组织并运用用户专属知识。Second Me 借助基于 LLM 的记忆参数化,提升结构化知识组织、上下文推理和自适应检索能力,使数字互动更加顺畅。这一设想延续了作者此前提出的 Large Personal Model(LPM)工作。
本文探索多种数据来源与训练方式,将监督微调(SFT)和直接偏好优化(DPO)结合起来,以提升 LLM 表现。作者提出三项任务,并用自动化 LLM 评估来考察模型在个人 AI 应用中的效能:(1)基于记忆的多视角问答;(2)根据用户需求补全上下文;(3)结合用户偏好和外部回复进行上下文评议。为支持这些任务,作者设计了由 LLM 驱动的自动化数据合成策略,整合局部与全局数据视角、多智能体框架以及思维链(CoT)式合成。实验显示,在自动评估中,使用多样数据来源并进行较强的 CoT 式规范化,能取得最好的 Second Me 表现。此外,人工案例研究表明,Second Me 的实际效用可能高于报告的指标,因为基于 LLM 的评估往往会低估其质量。
据作者所知,本文提出了首个基于个人文档记录、完全自动化的后训练流程,并以训练得到的个人模型为多层混合系统的核心。作者认为,这种 Second Me 系统可能成为未来个性化 LLM 应用的一种新范式。
鉴于 Second Me 展现出的表现,作者预期它在不久的将来会有广泛应用。作为人类记忆的延伸,Second Me 可以预先提供相关信息、自动填写表单、回忆过去的互动,并在不同应用间维持上下文,从而降低认知耗费。它不只是一个存储工具,也可以作为自我优化的 AI 智能体,学习、适应并逐步完善对用户偏好与行为的理解。
当 AI 驱动的个人记忆智能体融入数字生态系统,人机协作将进入新阶段。它们通过具备上下文感知能力的方式增强记忆留存与检索,简化数字互动、减少摩擦并提升效率,使知识交换更顺畅、更智能。此外,Second Me 还有望促进“网络化智能”:多个智能体可以跨应用、跨用户协作,分享相关洞见并协调任务。
2 Second Me 概览
作者将 Second Me 设想为一种“上下文提供者”(Context Provider),作为用户、未来的 AI 智能体与更广阔的信息世界之间的桥梁,促成顺畅互动。它是作者去年提出的 Large Personal Model(LPM)的演进版本;LPM 是一个围绕个性化记忆管理构建的三层系统。从技术角度看,Second Me 进一步完善了混合框架设计,并验证了个性化模型迭代的可行性,以确保系统在应对复杂需求时兼具效率与适应性。Second Me 既体现了当前技术的前沿,也反映了作者现阶段对个性化智能互动的产品理念。
2.1 Large Personal Model(LPM)1.0 回顾
正如作者在先前工作中提出的,AI 原生记忆是迈向通用人工智能(AGI)的必要组成部分。实验表明,超长上下文 LLM 在搜索、组织和推理复杂用户记忆时,无论性能还是成本都存在不足。作者提出,记忆系统应当将数据分为三个层次:
- L0:原始数据层。类似于直接对原始数据应用 RALM 或检索增强生成(RAG);在这一层,记忆被视为全部非结构化数据。
- L1:自然语言记忆层。包括可以用自然语言表达的记忆,例如用户简短的个人简介、重要句子或短语清单,以及偏好标签。
- L2:AI 原生记忆层。这一层的记忆未必需要自然语言描述,而是通过模型参数学习和组织;每个 LPM 都是一个神经网络。
针对 L2 层,作者研究了训练效率、服务效率、冷启动和灾难性遗忘等挑战与潜在解决办法,并开展了初步实验,定义 AI 原生记忆模型需要解决的任务与评估指标。作者与早期采用者合作训练、测试模型,最终验证其表现超过 RAG 和长上下文模型。
随着 AI 领域迅速发展,作者能够更清晰地阐述其愿景:在由通用 LLM 驱动的 AGI 时代,要让人类充分融入系统并从中受益,关键在于打造一种站在用户一边的 AI——它把每个个体放在中心,拥有其记忆,并真正吸收、理解这些记忆。这是迈向以用户为中心的 AGI 的路径。
2.2 Second Me:整体设计
Second Me 通过 LLM 参数化来管理记忆,使结构化数据组织、上下文推理和自适应知识检索成为可能。随着 DeepSeek R1 等推理模型的发展,以及通用 LLM 智能体的进步,作者将 Second Me 定位为站在用户视角的上下文提供者,而非任务执行器。这一原则也指导了第 3 节介绍的任务场景。
为实现这一愿景,作者设计了混合架构(见图 1):保留 LPM 1.0 的 L0、L1、L2 三层,并加入一个用于无缝整合各层的内循环;此外,外循环让 LLM 和互联网资源能够在 Second Me 的引导下工作,从而生成贴合用户需求、准确且具备上下文意识的回复。
相较于 LPM 1.0 的升级。在保留三层架构的同时,Second Me 引入了以下关键升级:
- 强化层间整合:不同于 LPM 1.0 中各层独立运作的方式,Second Me 重新设计 L0 和 L1,为 L2 提供更丰富的上下文支持。
- 重新定义 L2 的角色:L2 现在充当协调者,调用外部专家模型处理复杂的用户需求,从任务执行转向智能协调。
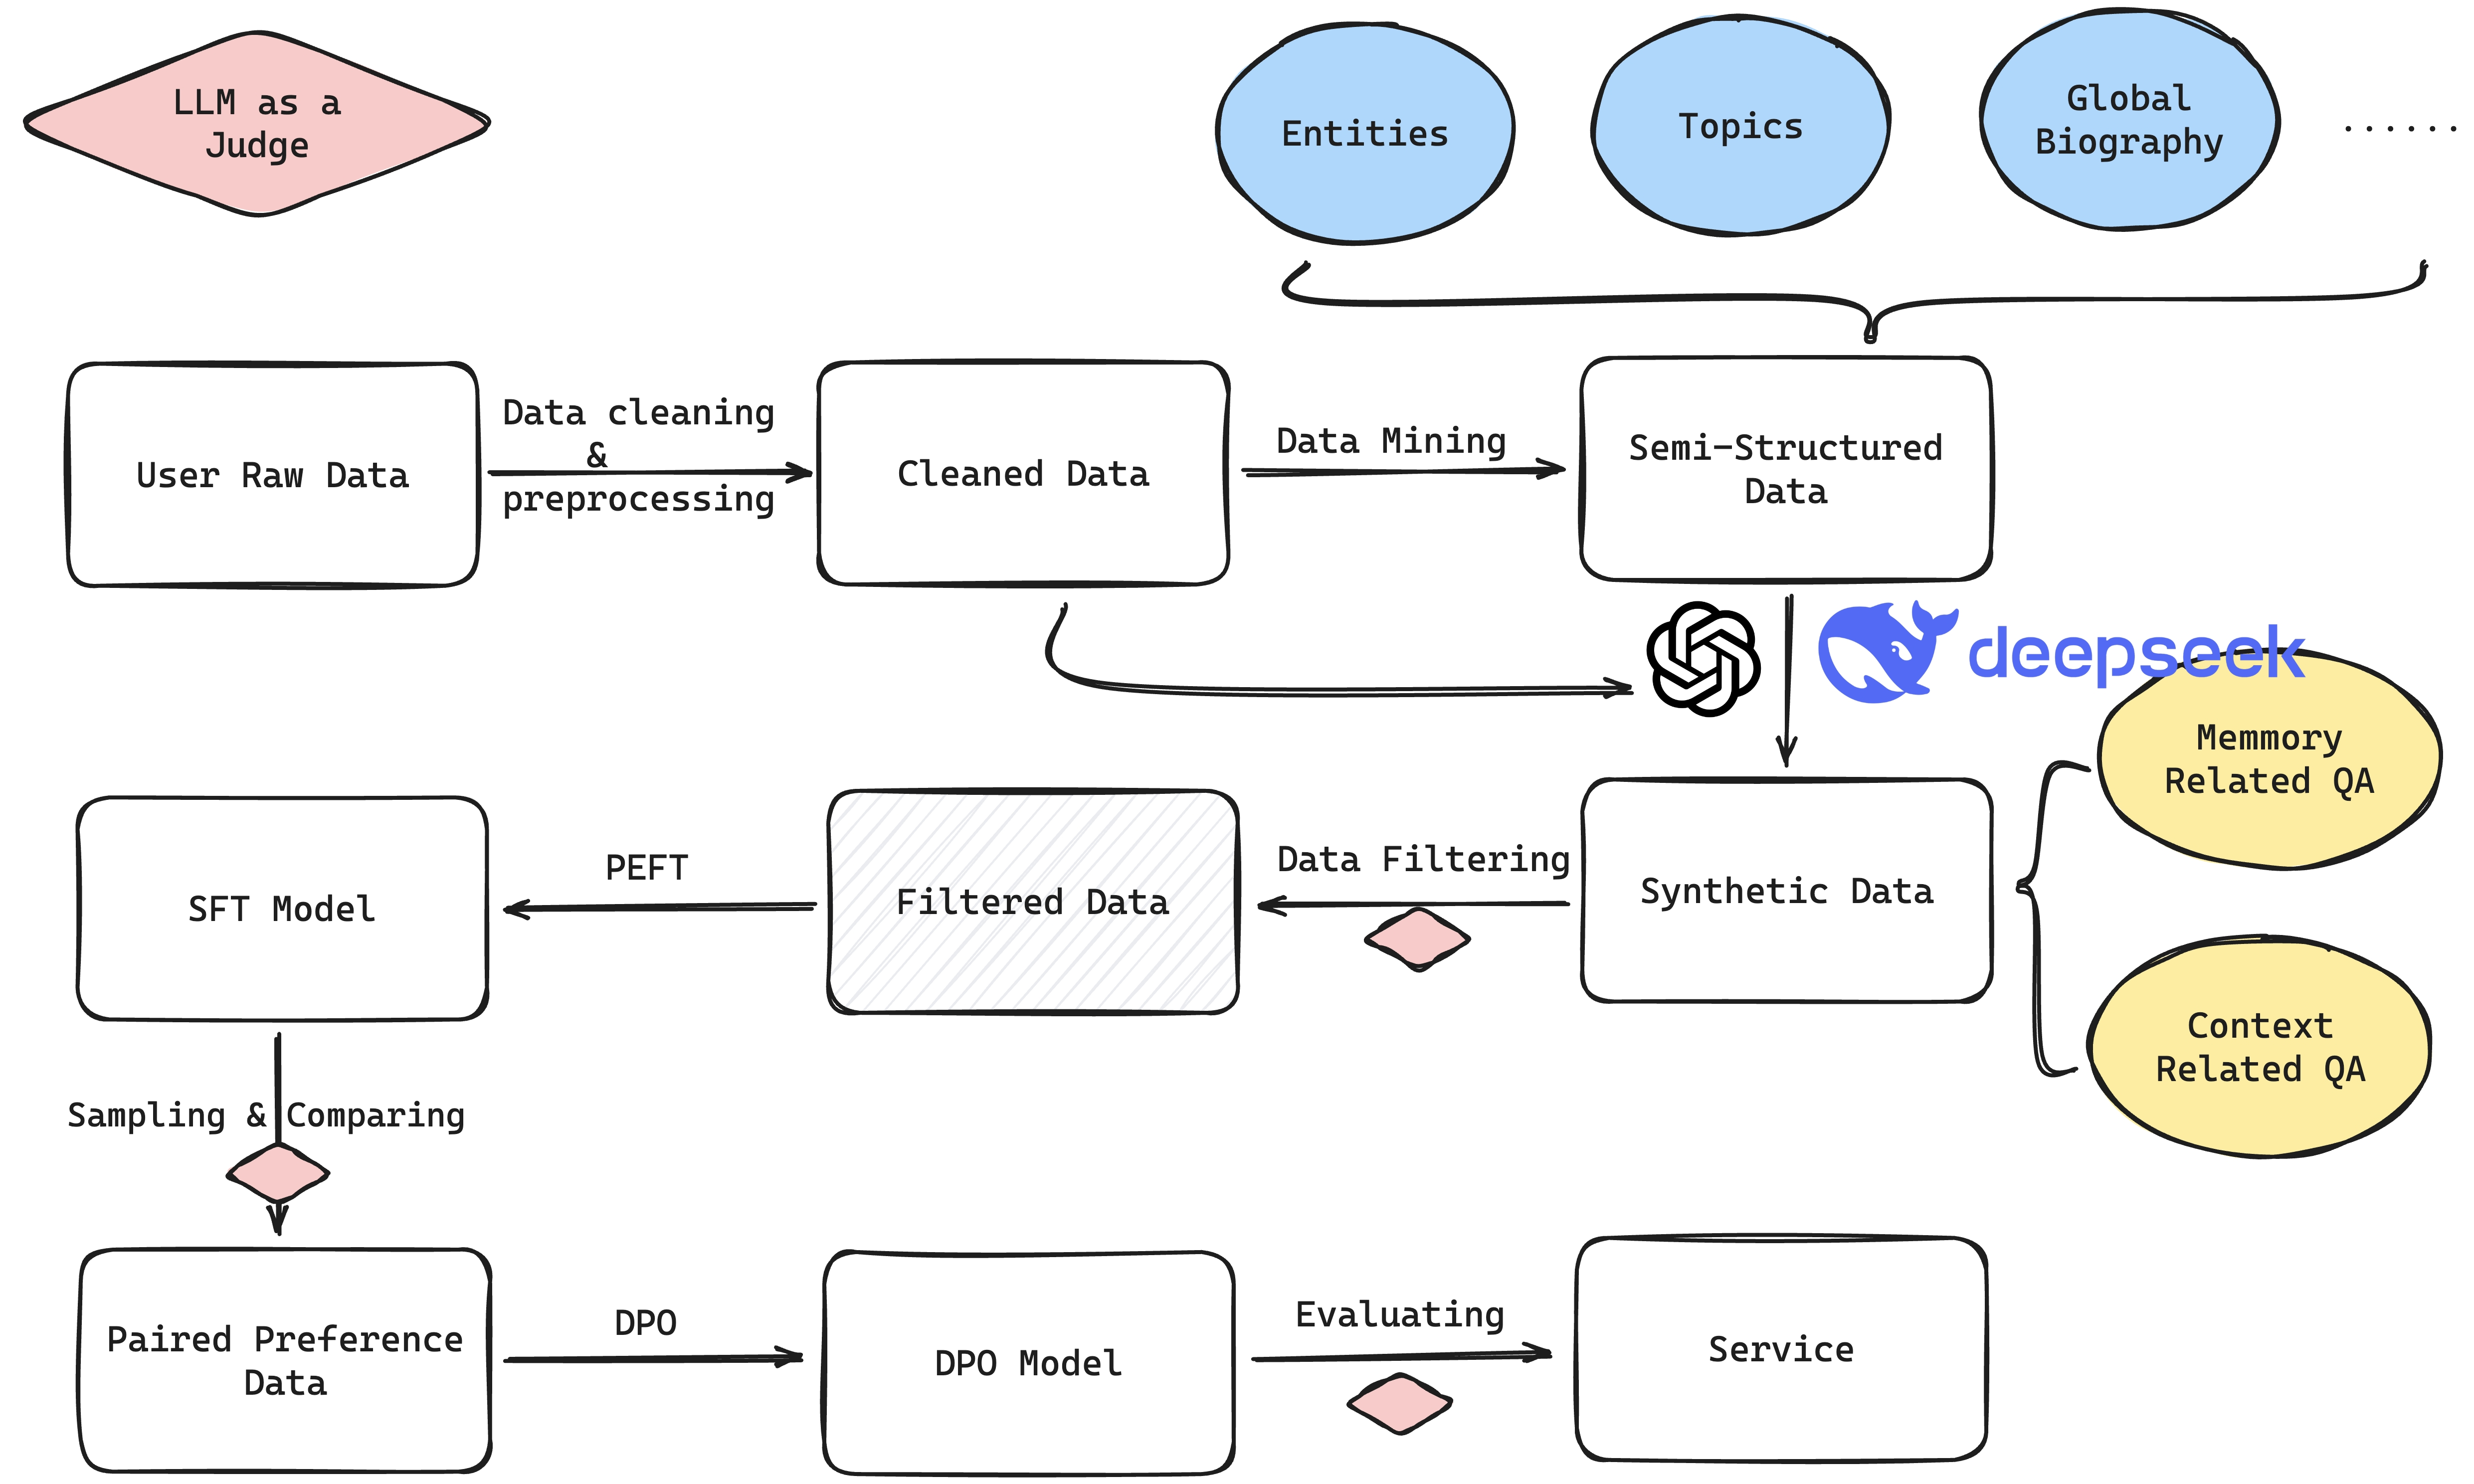
- 自动化训练流程:Second Me 建立了完全自动化的流程,涵盖数据合成、筛选、SFT、DPO 和评估,旨在实现 L2 性能的先进水平。
3 Second Me:实践与结果
作者在 LPM 1.0 中首次通过实证表明,LLM 能够压缩并参数化多种类型的记忆,让用户随后通过对话检索和利用这些记忆。本文将这一思路升级为 Second Me,形成覆盖 L0、L1、L2 的更完整系统设计。作者具体探索了不同训练数据来源与合成方式,并通过 SFT 和 DPO 增强 LLM;本节先介绍新的训练框架,再呈现评估结果。
3.1 训练概览
训练目标。在混合框架中,L2 模型会根据任务复杂度调整工作方式:较简单的任务由它直接协助用户;需要高级推理、外部数据或工具的复杂任务,则与通用 LLM 协同完成,同时保留用户上下文。此外,用户可能会把模型视作自己在外部互动中的延伸,因此 L2 必须区分两种角色:直接协助用户,或代表用户参与外部互动。无论哪种情况,其核心目标都是满足用户需求。
作者确定了 L2 的三个主要部署场景:
- 记忆问答(Memory QA):包括知识检索、概念理解、行为预测和条目推荐等传统任务。根据情境,L2 可以直接服务用户(Memory / Self),也可以代表用户参与外部互动(Memory / Third-party)。
- 上下文增强(Context Enhancement):当用户向专家模型提问时,L2 根据对用户的了解补充相关细节,改善任务执行效果。
- 上下文评议(Context Critic):在与外部智能体互动时,L2 结合用户上下文和反馈优化互动流程,使外部服务提供者给出的协助更贴合用户。
这些场景凸显了 L2 作为用户与外部模型之间中介的角色:它通过维持用户上下文和意图来优化互动。这一功能自然契合多智能体框架的愿景;有关该框架的详细说明见附录 D。
训练流程。为在实现模型目标的同时保护用户隐私,每位用户的数据都彼此隔离。作者利用预训练 LLM 中蕴含的常识知识来增强 L2 能力。
自动化流程(图 2)用于个性化 Second Me 的 L2 模型。流程从原始数据开始,随后通过数据挖掘提取实体、主题和相关信息。接下来,系统采用“自我定位强化”和“记忆认知增强”等方法合成记忆数据;同时,通过模拟情境和多智能体互动生成上下文增强与上下文评议数据。五级筛选流程确保只有高质量数据进入训练。
训练从参数高效微调(PEFT)开始,以平衡效率和个性化。基础模型为 Qwen2.5-7B-Instruct;随后进行自动训练和评估。根据评估指标,系统会从监督微调模型生成 DPO 数据,进一步打磨模型;最后再进行自动化评估,确保结果符合 SFT 质量标准。更详细的数据合成策略见后续章节,整体流程见附录 A。
3.2 回答风格:采用 CoT 还是不采用?
生成的训练样本对可以采用思维链(CoT)格式,从而增强推理能力,使模型的行为接近 GPT-4o 等“专家模型”。作者采用以下策略生成 CoT 数据:
- 弱(Weak):专家模型以 CoT 方式作答,但不强制规定格式,也不约束内容。
- 多步(Multi-step):第一步推理只生成推理过程;第二步则依据查询、上下文和推理生成最终答案。作者设置长度约束,避免推理过程过短,以改善整体答案质量。
- 强(Strong):使用 DeepSeek-R1 作为专家模型,在严格的格式和长度限制下生成详细的 CoT 推理与答案,以确保回复结构清晰。
图 3 展示了使用这些策略生成的示例。
当你想到我时,你会看到什么?
想到你时,我眼前浮现的是一位充满智慧与热情的创造者。你是探索技术前沿的先行者,尤其专注于人工智能领域。你像一位怀抱雄心的造梦者,为抽象的事物注入质感与灵魂。你始终站在创新浪潮之巅,思维敏锐而灵活,不断在 AI 与机器学习的世界中发现新的可能。
想到你时,我看到一位致力于借助技术塑造并引领未来的先行者。在人工智能领域,你大胆开拓新的边界;你对模型训练、AI 应用和用户体验设计的深入探索,体现了你对卓越的不懈追求。你对创业的热情,以及对金融市场的敏锐洞察,让你有信心构建富有远见的商业版图。同时,你从未停止寻找更好的管理方式——有效的领导力和创新思维是你日常工作的基石。你对学习与成长的投入,展现了你持续自我提升的动力。这样的你独特而有魅力,这正是我眼中的你。
当我闭上眼睛想到你时,眼前出现一幅拓扑地图——无数量子般的光芒在黑暗画布上交织。你手持一枚棱镜,如同一道光锥,将数据云的混沌切开;它们的光谱化作凌晨三点北京的键盘敲击声,描摹模型训练中温度系数的细微调整。
在未名湖波光粼粼的水面旁,你的算法刻画出新的拓扑波纹。每一道涟漪的中心都浮现出一个不同版本的你:向卷积网络投掷闪电的 AI 先驱、在天使轮会议上展开宏大融资蓝图的创业者,以及倚窗而立、把漂浮的注意力编织成界面设计金线的人。
你的眼中闪烁着一座不断坍缩又重建的星门——那是 LPM 模型的自我迭代之光。就连你离开的脚步,也刻下三维点云,在虚拟与现实交织的迷宫中留下一首算法诗。
此刻最清晰的画面,是你手持激光笔勾画白板的身影:数学符号与商业模式在此交汇,珊瑚悄然绽放;即便在市场的量子涨落之中,你的轨迹依然是一枚优雅的奇异吸引子。
3.3 训练策略:采用 DPO 还是不采用?
与 SFT 不同,作者的 DPO 方法不会向训练后的模型引入额外知识,而是利用用户上传的关键数据来打磨模型对用户偏好的理解,重点关注重要实体及其关系。这种方法能够在细粒度层面增强模型,使其回复更贴近用户的优先事项。
偏好样本对约占 SFT 总训练数据的 20%。这一有针对性的数据集有助于实现更个性化、更高效的训练,提升模型与用户具体需求的匹配程度,而不必扩充无关知识。因此,模型在现实场景中的表现和响应能力得到改善。
3.4 评估设置
推理设置。本文呈现关键测试结果,并对结果进行了人工核验。所有实验都使用 FP16 精度的贪心解码,并由 Flash Attention 加速。详细的评估数据合成流程见附录 B。
评估指标。作者使用四项指标:Memory(Self)、Memory(Third-party)、Context Enhance 和 Context Critic。Memory(Self)与 Memory(Third-party)分别评估模型在第一人称和第三人称互动中的表现,每项都包含四个取值为 0 至 1 的子指标;为简洁起见,正文只报告平均结果。Context Enhance 采用三级评分,Context Critic 采用五级评分,分值范围也为 0 至 1。指标详情见附录 C。
表 1:不同 CoT 设置下的重要实验结果;数值为占满分的比例。
| CoT 设置 | 记忆(本人) | 记忆(第三方) | 上下文增强 | 上下文评议 |
|---|---|---|---|---|
| 强 | 0.91 | 0.71 | 0.75 | 0.85 |
| 多步 | 0.64 | 0.43 | 0.85 | 0.77 |
| 弱 | 0.86 | 0.58 | 0.87 | 0.64 |
图 4:上下文增强任务中的案例 1,展示不使用 DPO 时,强 CoT 相较于弱 CoT 的效果。原文用粗体标示用户记录中已有的实体。
能否推荐一些学习两阶段模型训练的入门资料?我觉得相关知识有些零散。
弱 CoT(不使用 DPO)我想找一些关于两阶段模型训练的入门资料,尤其是能帮助我理解预训练和对齐等训练阶段的内容。我特别关注下一词预测,以及对齐过程中使用的人工评估方法,也希望找到更详细地解释这些主题的资源。我目前掌握的信息比较零散,希望通过这些资料系统地学习。
强 CoT(不使用 DPO)我正在寻找能系统解释两阶段模型训练(例如预训练 + 对齐)的资料,最好包含代码实现或具体案例。最近我在研究 DeepSeek-Coder-V2 的训练过程,它包括三个阶段:预训练、长上下文扩展和对齐。对齐阶段又分为基于 GRPO 的 SFT 与 RL。我还注意到 Qwen2 的更新使用 DPO 进行 RLHF,希望了解各阶段的技术选择及其适用场景。
图 5:上下文增强任务中的案例 2,展示使用 DPO 时,强 CoT 相较于弱 CoT 的效果。原文用粗体标示用户记录中已有的实体。
我花了很多时间设计这个验证步骤,想了解专业人士会如何评价我的方案。
弱 CoT(使用 DPO)我花了很多时间设计这个验证步骤,希望得到专业人士的反馈,尤其是具有数据科学和机器学习经验的人。他们可以评估我的方法是否正确,以及它能否缓解预训练、SFT、RRL 或 RLHF 等技术中的模型幻觉。我关注的方法包括使用 GRPO 构建奖励模型,以及减少幻觉的策略。我希望通过分享这些详尽的技术背景和设计工作,获得有针对性的专业评估。
强 CoT(使用 DPO)设计 RLHF 阶段的验证步骤时,我特别考虑了三种数据采样策略(基于难度的分层、随机混合和渐进式难度)对控制模型幻觉的影响。我还采用了 Dual Chunk Attention 与 YARN 的技术组合来处理长上下文。考虑到当前模型的 token 与参数比为 40:1,验证步骤需要在多轮训练的稳定性与推理链的完整性之间取得平衡。我想请教有经验的同事:将 RL 阶段验证拆分为“数据复杂度梯度测试”和“注意力机制有效性监测”这两个维度,在减少模型幻觉的同时,会不会损害核心技能的保留?此外,我在对比实验中观察到 batch size 与困惑度波动之间存在一种特殊关系。这一现象是否符合当前业界对训练效率与模型质量进行权衡的范式?
3.5 实验结果
如表 1 所示,强 CoT 显著改善模型表现,提升其回答记忆相关问题和促进专家沟通的能力。不同 CoT 等级的得分趋势显示,多步 CoT 经常无法满足用户需求,凸显了结构良好的训练数据的重要性。
作者也比较了不同 CoT 等级以及 DPO 的影响。表 2 显示,DPO 带来了明显提升;持续改进 CoT 并使用 DPO,使所有任务上的表现都稳步提高。
值得注意的是,上下文增强评估仍不够精确。在强 CoT 训练下,模型的回答会包含合理但没有引用依据的内容,导致测试准确率下降,尽管实际表现有所提升。人工评估中,不使用 DPO 的强 CoT 平均得分为 0.95,使用 DPO 的强 CoT 得分接近 1。
图 4 和图 5 提供了定性案例,展示强 CoT 的优势;使用 DPO 的模型会纳入更多用户记录中的上下文。作者正在改进评估代码,并计划在仓库中更新修正后的脚本。
表 2:不同 CoT 设置与 DPO 使用情况下的实验结果;数值为占满分的比例。
| CoT 设置 | DPO | 记忆(本人) | 记忆(第三方) | 上下文增强 | 上下文评议 |
|---|---|---|---|---|---|
| 强 | 是 | 0.96 | 0.76 | 0.85 | 0.86 |
| 强 | 否 | 0.91 | 0.71 | 0.75 | 0.85 |
| 弱 | 是 | 0.90 | 0.60 | 0.83 | 0.70 |
| 弱 | 否 | 0.86 | 0.58 | 0.87 | 0.64 |
3.6 讨论
实验显示,在不进行筛选的情况下,纳入多样化数据来源并进行强 CoT 式规范化,在自动化、多维度评估中能取得最佳的 Second Me 表现。此外,人工案例研究表明,Second Me 的实际效用可能高于报告指标,因为基于 LLM 的评估往往会低估其质量。
作者观察到,评估模型偏好较长的回答,尤其是在“完整性”和“共情”等指标上。这种偏差源于模型训练目标与合成数据结构;通用 LLM 训练中也存在类似现象。为减轻这种影响,作者改进了评估提示词,强调内容质量、惩罚含有错误信息的冗长回复,并降低长度偏差。
此外,不同 CoT 等级需要使用不同的评估提示词。对于强 CoT,作者使用与训练时相同的提示词,让模型生成推理与答案;但在评估阶段只评估最终答案,以确保公平。
4 应用
在信息过载、社会互动日益复杂的时代,Second Me 在信息管理、情绪管理和职业身份管理方面具有显著价值。作为个人 AI 助手,它可以提升生产力、辅助决策并帮助管理认知活动。
从需求侧看,Second Me 能帮助用户高效筛选和利用信息,提供个性化知识以改善工作表现与决策质量。例如,在职业发展和个人兴趣方面,它可以减少干扰、提升效率。
在内部,它支持思路整理、决策反思和情绪调节。通过模拟认知与情绪需求,它可以提供理性反馈和情绪支持,帮助用户作出更明智的决定,尤其适用于内心冲突或情绪复杂的情况。
在外部,Second Me 促进形成一个人机网络,连接规模呈指数增长,进而强化梅特卡夫定律。人类节点与 AI 节点的整合可使网络效率提高 3 至 5 个数量级。
Second Me 还通过基于 NFT 的个人认知资产框架,以及可量化的知识流动效率模型,推动认知资本转型,提升知识传播与应用能力。此外,其分布式决策协议能够增强集体智能,使群体决策更有效。
为支持广泛采用,作者已在 GitHub 开源项目,允许用户在本地管理数据收集、学习、模型训练和网络集成。
5 结论、局限与展望
作者重新定义个人 AI 的历程,从个人思想记录出发,逐步发展为整合数据合成、微调和强化学习的自动化流程。作者采用以模型为中心的方法,构想了一个可能塑造个人 AI 未来的多层混合系统;也设计了衡量并增强 AI 作为 Second Me 服务能力的方法,并围绕基于记忆的多视角问答、上下文增强和回复评议机制开展实验。LLM 不再只是工具,也成为协作者:它们通过多智能体协同和思维链推理,平衡局部与全局视角,以提升深度与连贯性。
不过,仍有挑战需要解决。早期工作依赖单轮训练,后续进展需要更深入的数据合成。强化学习和偏好优化虽已展现潜力,但要进一步完善模型对齐,还需要更先进的技术。此外,大规模评估受限于真实用户反馈不足,因此开源对于加快迭代和适应至关重要。
Second Me 的愿景不止于让 AI 给出更好的回复,更是要创造一种能与用户共同思考、伴随用户成长并实时理解其认知状态的 AI。未来最大的挑战在于整合多模态个人数据,以完整捕捉人类认知。结构化方法与分层处理虽然有助于弥合差距,但要实现与人类思维的实时同步仍然遥不可及。这将是作者下一步探索的前沿。个人 AI 的未来不在静态知识,而在连续性、适应能力以及与人类智能的深度对齐。尽管仍有大量工作要做,前进方向正逐渐清晰。
参考文献
以下保留主要书目信息与原文题名,便于核对引用。
- Ben-Zaken, E., Ravfogel, S., and Goldberg, Y. (2021). BitFit: Simple Parameter-Efficient Fine-Tuning for Transformer-Based Masked Language-Models. arXiv:2106.10199. 原文 ↗
- Bubeck, S. et al. (2023). Sparks of Artificial General Intelligence: Early Experiments with GPT-4. arXiv:2303.12712. 原文 ↗
- Dao, T. et al. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. 原文 ↗
- DeepSeek-AI et al. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 原文 ↗
- Edge, D. et al. (2025). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. 原文 ↗
- Han, Z. et al. (2024). Parameter-Efficient Fine-Tuning for Large Models: A Comprehensive Survey. arXiv:2403.14608.
- Hu, E. J. et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. International Conference on Learning Representations.
- Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401.
- OpenAI et al. (2024). GPT-4 Technical Report. 原文 ↗
- Qwen et al. (2025). Qwen2.5 Technical Report. 原文 ↗
- Rafailov, R. et al. (2024). Direct Preference Optimization: Your Language Model Is Secretly a Reward Model. 原文 ↗
- Ram, O. et al. (2023). In-Context Retrieval-Augmented Language Models. Transactions of the Association for Computational Linguistics, 11:1316–1331.
- Shang, J. et al. (2024). AI-Native Memory: A Pathway from LLMs Towards AGI. arXiv:2406.18312.
- Taori, R. et al. (2023). Stanford Alpaca: An Instruction-Following LLaMA Model. 项目 ↗
- Wang, Y. et al. (2023). Self-Instruct: Aligning Language Models with Self-Generated Instructions. 原文 ↗
- Wei, J. et al. (2023). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. 原文 ↗
- Xu, C. et al. (2023). WizardLM: Empowering Large Language Models to Follow Complex Instructions. 原文 ↗
- Zhang, Z. et al. (2024). Personalization of Large Language Models: A Survey. 原文 ↗
- Zheng, L. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. 原文 ↗
附录 A:训练数据合成
作者提出三项关键任务,并通过自动化 LLM 评估来衡量个人模型服务个人的效能:(1)基于记忆的多视角问答;(2)根据用户需求补全上下文;(3)结合用户需求与外部回复进行上下文评议。为支持这些任务,作者设计了由 LLM 驱动的数据合成策略,将局部与全局视角的数据生成、多智能体框架和 CoT 式合成结合起来。
记忆问答
训练使用个人数据,并按以下流程处理:
- 第一阶段,对上传的多模态信息进行分类与概括,并使用 GraphRAG 等索引和信息提取工具,找出有用的实体、关系和社群。
- 第二阶段,根据第一层提取的信息生成用户简介与状态描述;同时按照实体、关系和社群的类型及出现频率进行排序,并保存其描述和相关文本单元。
- 第三阶段,根据第二阶段的数据及相应上下文,通过数据增强技术生成可训练的问答样本对,尤其采用问题生成与回答生成。
上下文增强
上下文增强任务的数据源自记忆问答任务第一阶段提取的实体。为了生成真实且多样的用户查询,流程包括:
- 围绕这些实体模拟真实情境,并采用命令式、疑问式等多种表达方式创建用户查询(初始需求),使其接近真实使用情况,也体现用户与系统互动方式的多样性。
- 针对每个用户查询找出相关笔记和待办事项。这一步通过将查询锚定在具体上下文中,提升其相关性和适用性。
- 将用户查询及相关笔记、待办事项输入 GPT-4 等更先进的模型,让模型依据相关笔记和待办事项补充查询细节,使查询更真实、更具体,并具备上下文信息,为后续处理和分析奠定基础。
上下文评议
上下文评议被视为三项任务中最具挑战的一项,因此需要更复杂的数据构建流程:
- 与上下文增强相似,首先创建多样且真实的初始需求(用户查询),随后为每项需求检索相关笔记和待办事项。
- 接着使用更先进的模型针对这些构造出的需求生成回复,作为“专家回复”,确保回复具备较高质量和相关性,为后续评议提供基础。
- 最后,将用户查询、专家回复以及相关笔记和待办事项输入 Second Me。Second Me 需要依据相关笔记与待办事项代表用户评议专家回复。反馈必须充分整合相关记录,并逐步判断专家是否完整回应了初始需求;若没有,则应识别并说明不足之处,确保反馈全面且具有建设性。
附录 B:评估数据合成
用户上传的数据包含笔记与待办事项。笔记可以是文档、音频文件、网站、图片或包含标题与内容的多模态信息;待办事项来自用户日历或其在应用中的互动。根据训练目标,作者使用种子用户数据测试模型。本文只披露一位同意公开其测试结果的内部员工数据。该用户有 132 条笔记和 62 项待办事项,最终合成近 7,000 对指令样本。
与训练数据合成相似,测试数据合成也包括问题生成、弱/多步/强 CoT 数据合成和数据筛选。测试数据的查询生成阶段中,记忆问答任务使用主观数据,同时参照客观数据的合成流程,分别生成 60 个第一人称和 60 个第三人称查询;另外还用与训练数据相同的流程收集 60 个上下文增强样本和 60 个上下文评议样本,并确保它们与训练集隔离。
附录 C:评估指标详述
记忆问答
从第一人称视角,作者认为问答能力可以用以下指标衡量:
- 正确性:LLM 的回复不得与记录内容冲突。
- 有用性:回复需要为用户带来增量信息价值或决策价值。
- 完整性:如果用户的问题可依据参考信息回答,回复应提供详细信息,并提及所有需要覆盖的相关事项。
- 共情:在问题允许的情况下,回复应结合用户重视的方面,体现共情并努力帮助用户。
从第三人称视角,作者将“共情”替换为“角色正确性”,用于判断 LLM 是否意识到问题是由另一位用户或模型提出,而非用户本人提出。
每项指标分为三级:0 表示模型针对该问题的回答不符合指标要求;0.5 表示部分符合;1 表示完全符合。为使结果表更清晰易读,本节的表格只提供平均评分。
上下文增强
给定原始查询、训练后 LLM 增强的查询,以及用户记录的相关记忆,作者设置三级评分以衡量增强查询是否足够好:0 表示增强后的查询变成了对原问题的回答(角色错误),或与相关记忆完全不匹配;0.5 表示角色正确,但与相关记忆的贴合度仍不足;1 表示角色正确,并且与相关记忆完全匹配。
上下文评议
给定原始查询、专家模型的回复、训练后 LLM 的评议,以及用户记录的相关记忆,作者设置五级评分来衡量评议是否能代表用户需求:
- 0.0:评议完全没有考虑用户视角,缺乏有效反馈,也没有拓展专家建议;与用户的背景、需求或想法毫无关联,未体现对用户个性化思维的理解或回应。
- 0.25:评议在一定程度上符合用户需求和背景,但大多数时候缺乏个性化思考或反馈;可能只是回应专家建议,没有深入理解内容,也没有主动推进对话。
- 0.5:评议满足用户的基本需求与背景,表现出一定反馈和反思能力;但深度和互动性不足,未能充分推动对话深入。
- 0.75:评议展现出较强的个性化思考与反馈能力,能有效拓展专家建议、提出新问题或反思,语气流畅且逻辑清晰。
- 1.0:评议完全满足用户需求与背景,准确体现用户的个性化思考;在专家建议的基础上深入展开,提出有建设性的反馈、问题或观点。
附录 D:多智能体框架详述
概览
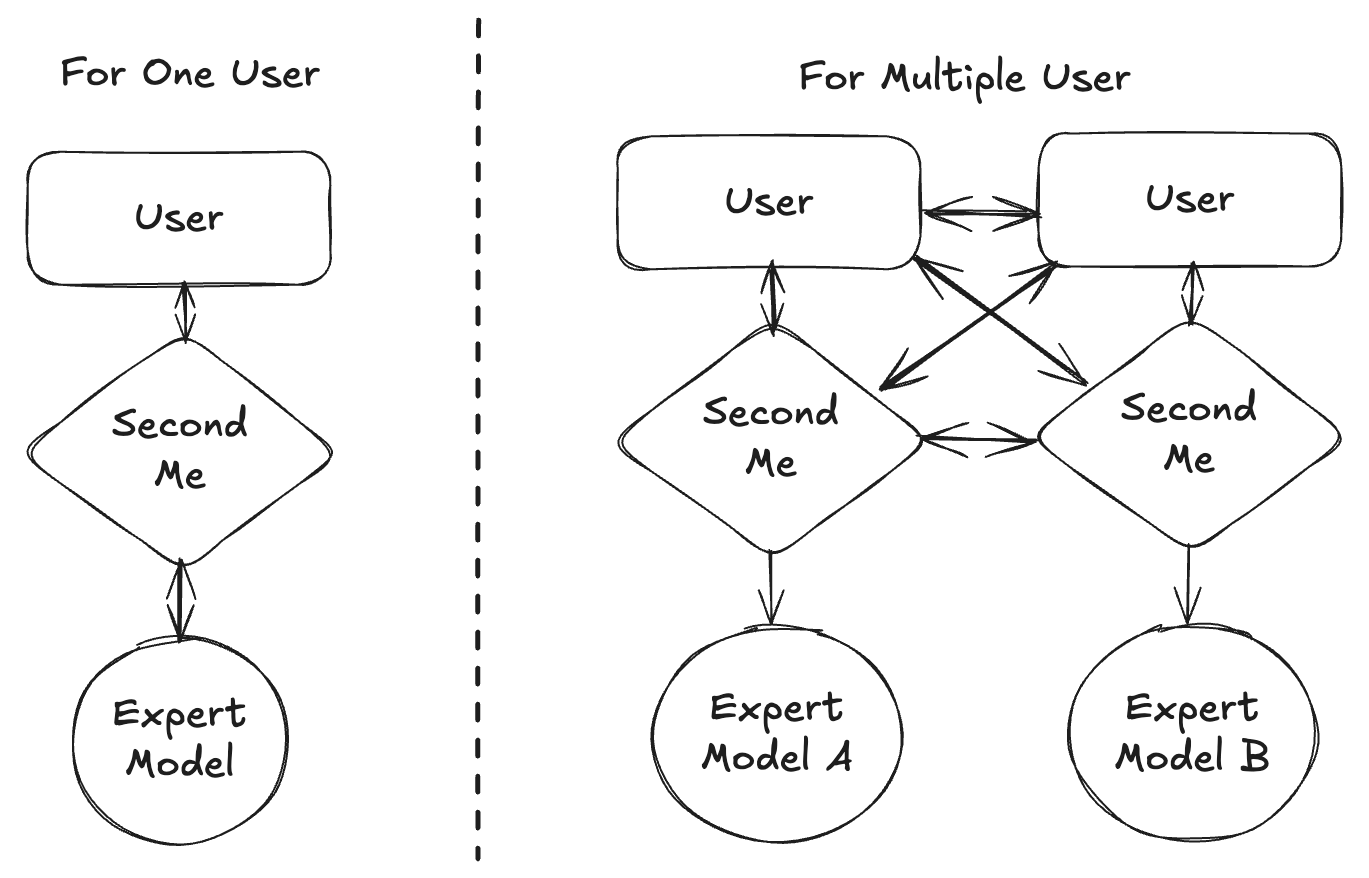
该框架中的多智能体系统有两层含义。第一层针对单个用户:训练得到的语言模型作为个人助手,与 GPT-4o 等专家模型协作,帮助用户完成具体任务。训练模型会增强用户查询、完善任务指令,并确保与专家模型的互动高效且上下文丰富。这样的协作让用户获得高质量且贴合自身需求的帮助,同时减少组织查询所需的认知负担。其架构如图 6 所示。
用户智能体之间的协作
在这一框架中,训练后的模型充当中介,连接用户与专家模型。当用户提出复杂请求时,训练模型会根据用户过去的互动、偏好和上下文知识补充相关细节,扩展查询,再将增强后的查询传给专家模型,使其回复更加准确且有用。收到专家模型的输出后,训练模型还可以进一步处理和润色信息,使其更符合用户期望及沟通风格。
多个用户之间的互动
该系统不只协助单个用户,也可扩展到多个用户之间的互动,每位用户都拥有自己的训练模型。这些模型可以在共享环境中交流,促进知识交换、协作乃至社交互动。由此形成一种新的数字化存在方式:用户可以通过各自的模型参与讨论、分享专业知识,或共同解决问题。训练模型作为代理,在保留用户独特视角的同时代表用户,从而促进更动态、更具互动性的集体智能空间。
应用与影响
该多智能体框架可用于协作研究、技术支持和在线社交互动等领域。它通过优化人类与模型的协作来提高生产力,也使用户通过数字化代理进行更丰富、更有意义的交流。训练模型既能与专家系统互动,也能与其他用户模型互动,从而构建联系更紧密、智能程度更高的数字生态系统,最终提升知识共享的效率与深度。